
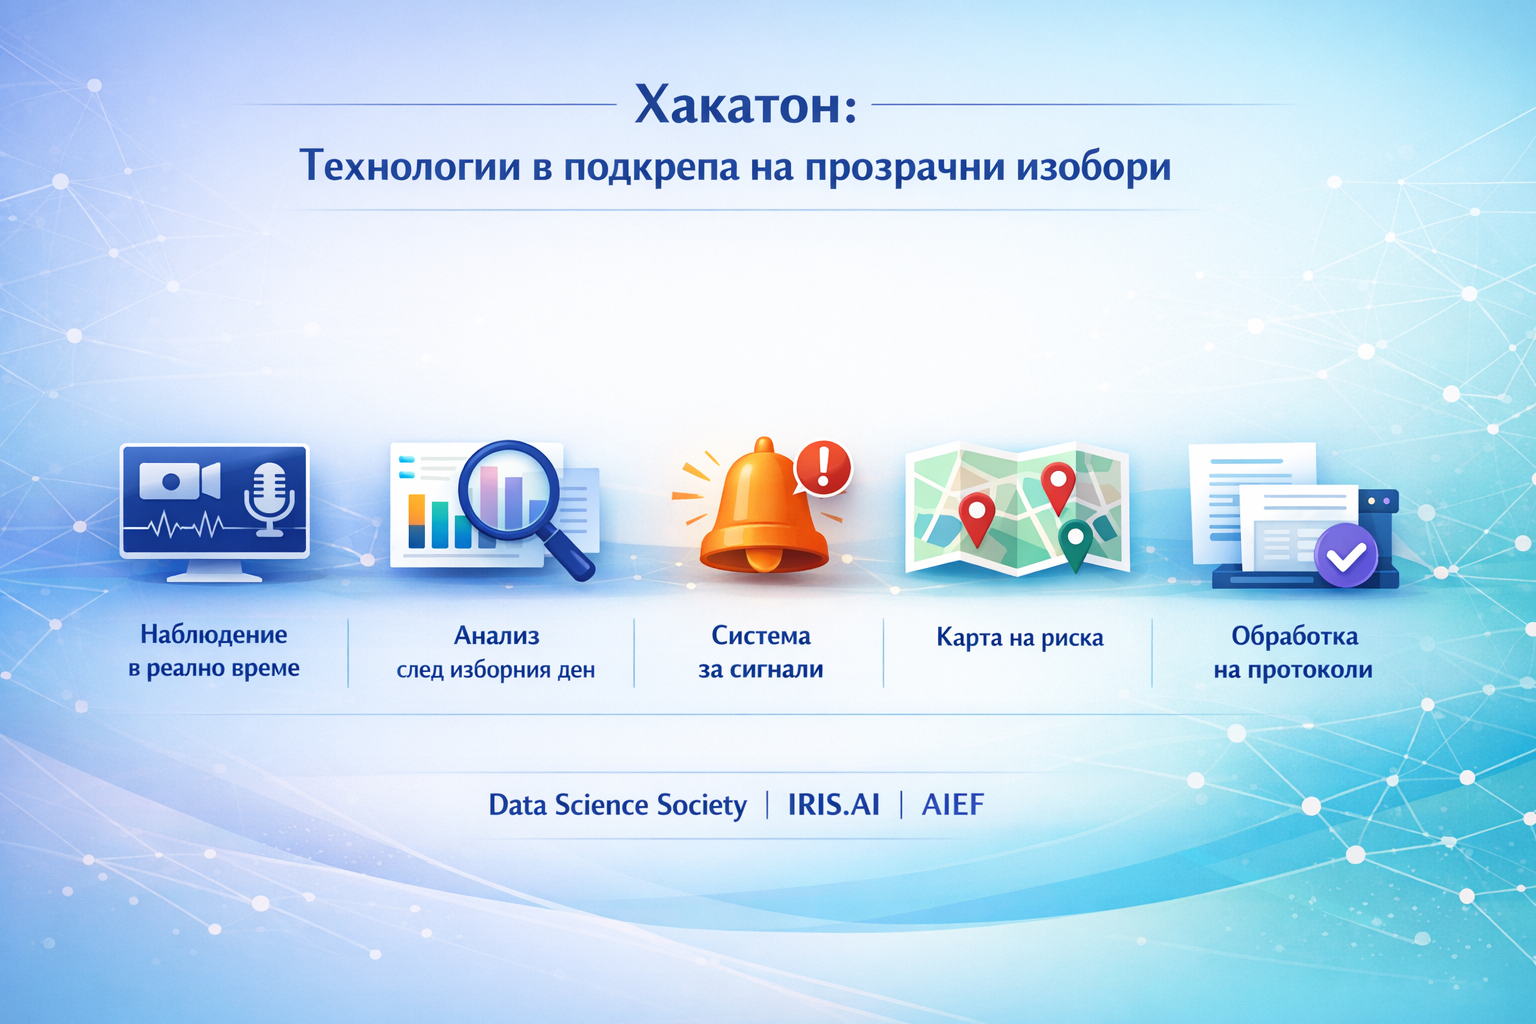
На 28 март в събота проведохме интензивно събитие, фокусирано върху това как данни, софтуерно инженерство и изкуствен интелект могат да подпомогнат прозрачността и доверието в изборния процес.
В рамките на над 11 часа участници с разнообразен професионален опит работиха по няколко ключови направления:
🔹 Обработка на данни в реално време (наблюдение в изборния ден)
Фокусът беше върху изграждане на архитектура за обработка на данни в реално време по време на преброяването (приблизително 20:00-23:00).
Работихме върху:
- прием и обработка на потоци от данни (видео/аудио)
- откриване на събития (аномалии, липса на активност, прекъсвания)
- поток от обработки за бързо сигнализиране
Целта е минимизиране на забавянето между възникване на събитие и неговото валидиране от човек.
🔹 Пакетни анализи (след изборния ден)
След качване на данните фокусът се измества към по-задълбочен анализ.
Тук се разглеждаха:
- синхронизация между различни източници (видео, протоколи, официални резултати)
- проверки за съгласуваност на данните
- откриване на статистически отклонения
Този слой позволява последващ анализ и откриване на по-фини несъответствия.
🔹 Интелигентна система за сигнали
Един от ключовите компоненти.
Разработена беше концепция и прототип за:
- централизирано управление на сигнали
- приоритизация според риск и контекст
- интелигентно разпределение към доброволци
- обратна връзка (потвърден/отхвърлен сигнал)
Системата е проектирана да бъде разширяема – да приема сигнали както от хора, така и от автоматизирани модели (аудио и видео анализ).
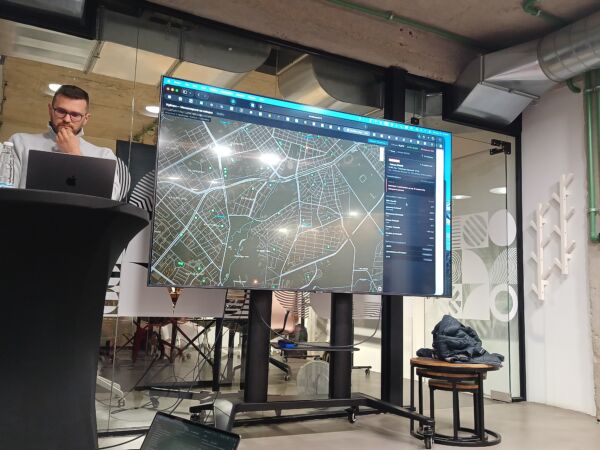
🔹 Интерактивно табло (карта на риска)
Създаден беше прототип на карта на България, в която всяка секция се оценява спрямо риск.
Използвани бяха:
- исторически данни
- поведенчески индикатори
- статистически показатели
Резултатът е инструмент за приоритизация – показва къде има най-голяма вероятност да възникнат проблеми.
🔹 Анализ на аудио
Екипите работиха по:
- потискане на шум и подобряване на качеството
- модели за преобразуване на реч в текст (speech-to-text) за български език
- подготовка на данни за последващ езиков анализ
Целта е извличане на структурирана информация от неструктурирани разговори – например индикации за проблеми или нерегламентирано поведение.
🔹 Анализ на видео
Фокусът беше върху:
- основно наблюдение (дали камерата работи)
- разпознаване на позицията на камерата (дали следи процеса)
- задействане на сигнали при отклонения
Това е първа стъпка към по-сложни приложения на компютърното зрение.
🔹 Поведенчески анализ на секции
Използвани бяха данни от предходни избори за:
- откриване на аномалии в резултатите
- сравнение спрямо „нормално“ поведение
- групиране на секции по профил
Това позволява изграждане на предварителна оценка на риска още преди изборния ден.
🔹 Автоматична обработка на протоколи
Една от най-практическите задачи.
Работихме върху:
- разпознаване на текст от изображения (OCR) върху ръчно попълнени документи
- структуриране на данните
- проверки за съгласуваност
Целта е да се намали човешката грешка и да се ускори процесът на дигитализация.
💡 Какво научихме?
Комбинацията от различни експертизи (наука за данните, инженерство и предметна експертиза) е ключова за решаването на сложни обществени проблеми.
🙏 Благодарим на всички участници – енергията, фокусът и желанието да се допринесе бяха на изключително ниво.
Вярваме, че дори малки стъпки в тази посока могат да имат реален ефект върху прозрачността и доверието в процеса.
Повече информация за кода и решението може да намерите в repo-то на събитието – https://github.com/datasciencesociety/elections